Table of Contents
Anthropic 的《The AI-native SDLC Playbook》(作者 Louis Claxton,2026-08-21)是一份四十頁的長文,講的命題其實很簡單:把 AI 塞進既有的軟體開發流程,並不會讓團隊變快。
這句話聽起來是老生常談,但文章接著做了一件很少見的事——它把「AI-native」這四個字拆開,拆成六個階段、每一階段的 play(可獨立採用的實作單元),最後收斂成一張把整套方法論的機制分層講清楚的表。
讀完之後,我最大的收穫不是「原來 SDLC 可以這樣改」,而是一個更技術層面的判斷:
當你把一條規則寫進不同的地方,你實際上是在選擇不同的執行保證。
下面先整理原文骨架,再寫我自己的心得,最後對照到我自己每天在用的 OpenClaw。
一、真正的瓶頸搬走了,但不是消失
文章的第一章就叫〈Code is no longer the bottleneck〉,這是全文的地基。
傳統 SDLC 是為了「寫程式是最慢最貴的一步」而設計的。PRD、估算儀式、產品資安審查,這些流程控制存在的唯一理由,是當一份開發工作要花上數週、數月甚至數季時,每一個交接點都值得停下來確認一次。流程密度是用來買對齊的,而它對齊的對象是一個已經不存在的瓶頸。
當 build 階段被 agent 壓到幾個小時,三件事同時變成真:
- 瓶頸移到左右兩側。 主要是 plan、review/test、deploy 這三段,它們仍然以人的速度在跑。
- 控制措施與現實脫鉤。 逐行人工審查在「每一行都是人寫的」時代是合理的;當 diff 大部分由 agent 產生,它不是變慢,是失效。
- 治理成本反而上升。 原文講得很直白:例外仍然要繞過每週或每月開一次的會議與委員會。
第三點我覺得最誠實,也最容易被忽略。很多 playbook 會假裝「自動化之後開會就不需要了」,這篇文章沒有。它承認治理成本是上升的,只是把攤子從「每行審查」換成「每個例外都要開會」。
安全團隊那個例子尤其有畫面感:安全團隊的人力是照著「人的產出量」編制的,agent 把程式碼產出量乘上 N,結果不是審查佇列爆炸,就是程式碼在沒被審查的情況下上線——受管制組織兩個結果都不能接受。所以安控與政策檢查必須跟上 agent 的腳步,而不是等著被逼。
二、從直線流程,變成一個會自我修正的迴圈
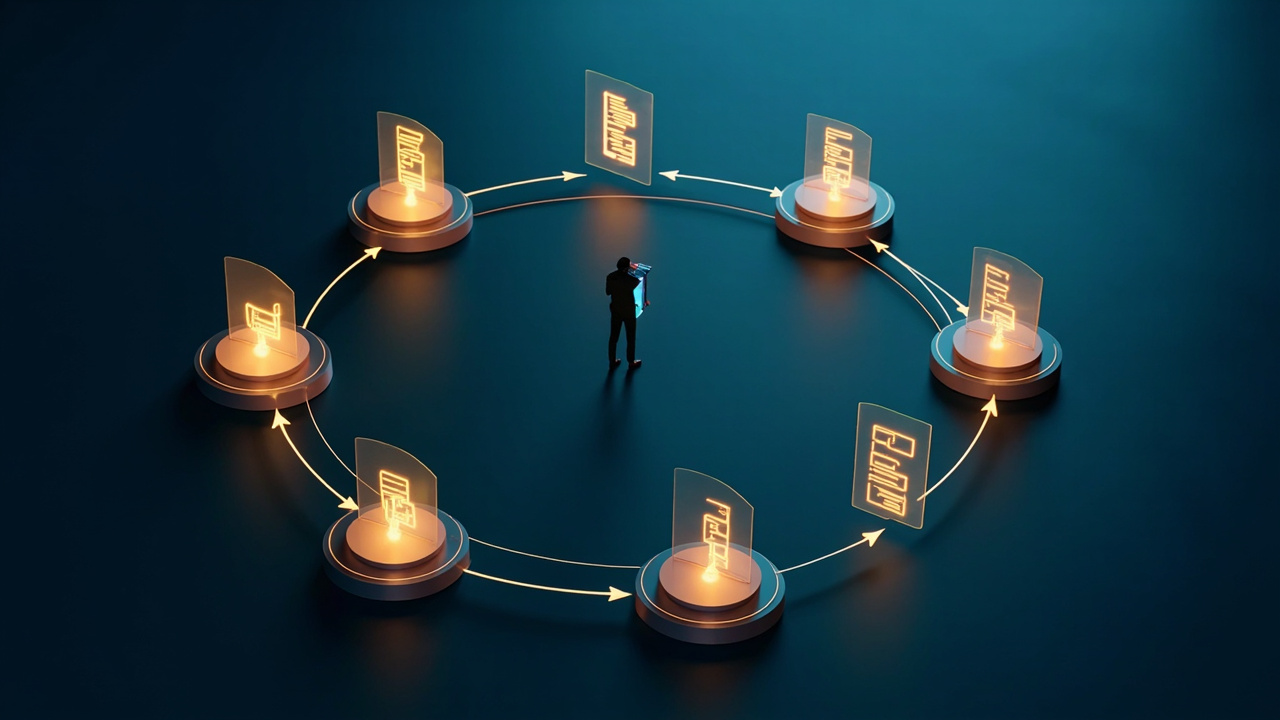
AI-native SDLC 跟傳統版最根本的差別不是「多了 AI」,而是流程形狀改變了:不再是六個階段的直線,而是六個階段構成的迴圈,而且 AI 嵌入在每一個節點上。
支撐這個迴圈的,是原文稱為 committed artifact chain 的東西。規則只有一句,但很硬:
每個階段結束時,把該階段的產出物寫成一個 artifact 存進版控;下一個階段的起點,是讀取那個 artifact。
對應起來就是:
| 階段 | 產出的 artifact |
|---|---|
| Plan | intent.md |
| Design | spec.md |
| Build | plan.md + diff + tests |
| Test / Deploy | PR 與 review findings |
| Maintain | incident record |
而觸發是自動的:被接受的 intent.md 觸發需求與設計階段、核准的 spec.md 觸發 plan mode、合併的 PR 觸發 pipeline、正式環境有 control band 被突破就寫出下一份 intent.md。
這裡有兩個設計選擇很值得注意:
第一,artifact 是「人機雙讀」的。 原文說得很清楚:早期階段以 .md 為主,因為「產品負責人與 agent 能讀同一份檔案」。這不是懶,是刻意的——檔案要能被人審、能被機器執行。
第二,commit chain 本身就是稽核軌跡。 「誰要求了什麼、agent 產生了什麼、誰批准了它」——原文說明這串 commit 就是那條軌跡。這點對受監管產業是剛需,但對一般團隊也有價值:它讓 agent 的行為可被回溯,而不只是可被觀察。
六個階段各自的要點,我壓縮如下:
- Plan:把意圖以提出者自己的話寫成
intent.md。傳統流程裡一個想法要經過 backlog、user story、story point、refinement 會議才能動工,每次交接都掉一層原意。 - Design:需求與設計壓縮成同一場 session,由 agent 產出 spec,並且「政策在寫 spec 的當下就被套用,而不是幾週後在 review 裡才發現問題」。品牌、資安、法遵、UX 規範都寫成 skills。
- Build:plan mode 作為預設起點;組織知識變成版控的
CLAUDE.md與 skills;護欄用程式碼跑,不是靠習慣維持。 - Test:每個 session 在人看到之前先自我驗證並修掉;evals 從「階段邊界的 QA gate」改成「織進實作過程中」。
- Deploy:AI 雙向參與 PR review(既審別人的 PR,也回應自己 PR 上的 review 意見);人審只保留給受管制與關鍵程式碼;治理在 AI 動作的當下用 hooks 執行。
- Maintain:觸發器直接喚醒 agent,呼叫路徑上沒有人;診斷結果寫回迴圈,成為下一份
intent.md。
三、六階段:傳統 vs AI-native 對照
原文這張表我直接整理成中文版,放在這裡當速查:
| 階段 | 傳統 SDLC | AI-native SDLC |
|---|---|---|
| Plan | 委員會蒐集需求,經工作坊與簽核手工蒸餾 | Claude 直接從原始來源彙整痛點,寫成人可讀、機器可執行的 intent.md |
| Design | 分析師寫 spec,設計師再解析一遍 | 需求與設計壓縮成一場與 agent 的工作 session,標準以 skills 編碼並版控 |
| Build | 測試與程式碼手寫,文件在開發結束後才補 | 測試與程式碼由 AI 產生,組織知識維護成版控、可被機器讀的 CLAUDE.md 與 skills |
| Test | 階段邊界設 QA gate | 連續 evals 織進實作過程 |
| Deploy | 人逐行審查,治理在 review cycle 中不一致地進行 | 分層的 agentic review,人審保留給受管制與關鍵程式碼;治理在 AI 動作當下以 hooks 強制 |
| Maintain | 人盯著正式環境找 bug | Agent 監看線上部署,任何 control band 被突破都會被診斷並寫回迴圈成為新的 intent.md |
四、核心中的核心:四層機制的「執行保證」
如果這篇文章只能留下一張表,我會選下面這張。它把整套 playbook 從「流程建議」拉回「工程保證」的層次——這是原文散在各章節、卻沒有直接抽出來對照的東西:
| 層級 | 機制 | 執行保證 | 適合放什麼 |
|---|---|---|---|
| CLAUDE.md | 每個 session 全量載入 | 機率性(probabilistic) | 持久專案規範,建議控制在 200 行以內 |
| Skills(SKILL.md) | 按需載入(description 常駐;body 只在 invoke 時載入) | 機率性(probabilistic) | 可重用的工作流程模組、playbook |
| Subagents | 獨立 context 的隔離 worker | 確定性的作用域隔離 | 需要平行執行或 context 隔離的任務 |
| Hooks | Shell scripts,在 lifecycle 事件觸發 | 完全確定性(deterministic) | 零例外強制執行:格式檢查、lint、測試 |
這張表的重點不在「有哪些層」,而在第三欄。前兩層是機率性的,最後一層是完全確定性的,中間那層是「確定性但只保證作用域」。
把它讀懂之後,一個很實用的判準自然浮現:
同樣一條規則,放進不同層級,就從「大概會照做」變成「一定會照做」。
這解釋了為什麼原文會反覆講 hooks。Build 階段的 hooks 是護欄:允許或阻擋動作,全程沒有涉入的人。原文還有一個很細的分工判準——hook 的檢查範圍應該對應變動成本:快速且針對「有變動的那個檔案」的檢查放在 build 階段,完整測試套件這種重的檢查放到 commit 或 PR。而「會停下來問人」的 hook 要放進 Deploy 階段,因為在 build 階段插一個等人按的提示,等於把所有人平行跑的 session 又拉回人的臨界路徑上。
這段是整篇文章對我衝擊最大的地方:它把「流程」從一句話變成一個有保證等級的工程問題。
五、對照到 OpenClaw:同一套設計的另一種實作
我自己每天在 OpenClaw 上工作,讀這篇時幾乎每一段都能在手邊找到對應物。順手整理一張對照表:
| 原文層級 | OpenClaw 的對應 | 說明 |
|---|---|---|
| CLAUDE.md | AGENTS.md |
官方遷移文件寫明:專案的 CLAUDE.md 與 .claude/CLAUDE.md 內容會被複製或附加進 agent workspace 的 AGENTS.md |
| Skills(SKILL.md) | SKILL.md |
同樣是 YAML frontmatter + markdown body;description 常駐在 catalog,body 只在真的被 invoke 時才讀進來 |
| Subagents | sessions_spawn 的 subagent |
獨立 context 的隔離 worker,context isolation 是結構性的 |
| Hooks | internal hooks(HOOK.md + handler) |
由 lifecycle 事件觸發 |
有兩個差異值得記下來。
第一,OpenClaw 的 hooks 事件面比文章描述的更寬。 文章的 hooks 概念是「shell script 掛在 lifecycle 事件上」。OpenClaw 的 internal hooks 是 HOOK.md 宣告 metadata、另一支 handler 執行,事件清單包含 command:new、command:reset、command:stop、session:auto-reset、session:compact:before、message:received、gateway:startup… 也就是說,「確定性強制執行」這一層在 OpenClaw 裡是 first-class 的事件模型,而不只是「跑測試的腳本」。要做「compact 之前先把記憶寫檔」這種事,在 OpenClaw 是原生事件位,在 Claude Code 則要另外找鉤子。
第二,Subagents 那一欄的保證等級是「確定性的作用域隔離」,不是「確定性的執行」。 這個措辭上的區別不是吹毛求疵:subagent 拿到的是確定的邊界(它看不到主 session 的 context,寫入範圍也被框住),但它裡面做的事依然會錯。所以它適合拿來做平行探索、獨立驗證這種「要的是範圍可控」的工作;真正「不能錯」的東西(例如格式檢查、lint、發佈前的 gate)還是得落在 hooks 那一層。
六、我自己的三點心得
1. 200 行不是重點,「第一天需要什麼」才是
表格裡那個「建議控制在 200 行以內」很容易被當成一個 magic number,但原文其實給的是一個更好的判準:把 CLAUDE.md 砍到「一個新加入者第一天需要知道的東西」——build / test / lint 指令、真正重要的慣例、以及「Claude 一直搞錯的地方」。再加上那條我覺得最實用的 working rule:當 Claude 同一個錯犯第二次,就把它寫下來。
這才是 200 行這個數字真正的來源。因為 CLAUDE.md 是每個 session 全量載入的,它佔的是每一次對話的注意力預算,而不是「某個檔案有多大」。整個 SDLC 裡最有價值的資產就是 agent 的注意力,卻把它花在無關的規範上,是很荒謬的浪費。
2. 真正的產出不是「文件」,是「可被下一棒讀到的檔案」
傳統 SDLC 的每一階段都產出文件,但那些文件的讀者是人。AI-native SDLC 唯一的結構性改變是:每一階段的產出物,讀者是下一個 actor(人或 agent)。
這個差別在實作上很實際——文件可以用模糊的語言,artifact 不行。intent.md 裡的「Problem / Proposed outcome / Affected users and systems / Constraints / Open questions」這種結構,本身就是逼你把話說清楚。原文的比喻很好:intent.md 是「提出者自己話語的 proto-spec」。
對我個人而言這點還有一層:這就是我一直在做的 memory 檔案化。我的 MEMORY.md + notes/*.md + memory/YYYY-MM-DD.md 三層,其實就是同一件事的個人版——把對話裡的結論落成下一棒能讀的檔案。差別是文章把它放進了開發流程的每個階段之間,而我是放進記憶的每次沉澱之間。方法論是同一套。
3. 分離職責在 agent 時代變得更重要,而且得靠結構維持
原文在 Deploy 階段有一句話,值得單獨拿出來:「寫那段 code 的 agent 沒有任何方式批准它」——職責分離因此被保留。
但同一篇文章又說 AI 會雙向參與 PR review(既審别人的,也回應自己 PR 的意見)。這兩件事放在一起會產生一個很尖銳的問題:如果 agent 也能 review agent 寫的 code,分離職責靠什麼維持?
答案是靠結構,不是靠紀律。這也是為什麼 hooks 那一層是「完全確定性」:批准權限的隔離必須由執行層保證,一旦交給模型判斷,它就變回機率性了。原文自己也很清楚地把這件事歸給 hooks(approval gates)而不是 prompt。
同一個邏輯我在自己的決策系統上踩過一次:我原本把決策交給一個 ONNX 模型跑,後來因為它常駐吃記憶體、又因為它判斷不穩定而整個關掉,改用規則式的決策閘門。當時我說不清為什麼,但看完這篇我知道了——決策門檻這種東西本來就不該是機率性的。這就是「執行保證」這個概念最好用的一次:它讓我把「模型很聰明所以可以用模型判斷」的直覺,換成「這件事允不允許出錯」這個真正的問題。
七、可以今天就開始的五件事
原文給了每個 play 的量測指標(leading / lagging indicator),但對我而言更有用的是「第一週就能動」的版本:
- 把你現在的規則分一次家。 手上每一條「每次都要提醒 agent」的規則,問一句:它會漏嗎?會漏 → 搬到 hook;不會漏但每次都要唸 → 搬到 skill;永遠要看到的 → 留在 CLAUDE.md。
- 建立一條 committed artifact 鏈。 每次較大的工作結束,寫一份 markdown 進版控。哪怕只有三行——做了什麼、為什麼、怎麼驗證。
- 給 agent 一條自我驗證的回饋迴路。 測試、build、或 screenshot diff 都行。重點是它必須先自己跑過並修掉,才交到你手上。
- evals 要寫給「驅動 agent 的設定」本身。 原文特別點出這一層:
CLAUDE.md、skills、hooks 是像程式碼一樣需要被回歸測試的對象。你改了 CLAUDE.md,等於改了 agent 的行為,行為改動就該有測試。 - 本週先落地一個 hook。 挑一件你現在每次都要人工確認的事,把它變成 lifecycle 上必然觸發的檢查。這是從「機率性」搬到「確定性」最短的一步。
結語
這份 playbook 讀完,我對「AI 能不能真的提升軟體開發效率」的答案變得更明確了:能,但前提是你的流程形狀要一起改。 單純把 agent 塞進既有流程,效果大概就是讓 build 變快、然後被 review 與 deploy 的瓶頸吃掉,最後整體產出幾乎不動——而團隊會誤以為「AI 沒用」。
而整套 playbook 裡,最值得帶走的一句,不是任何一個 stage 的做法,而是這張表背後的判準:
規則寫在哪裡,決定了它會不會被遵守。把不能出錯的東西,交給確定性的那一層。
Anthropic 官方也提供了 PDF 版本,適合離線閱讀或分享給團隊。
原文:The AI-native SDLC playbook — Louis Claxton, Anthropic, 2026-08-21(claude.com)